OpenAI opublikowało nowy oficjalny aneks do karty systemu bezpieczeństwa (System Card) dedykowany modelowi GPT-6 Luna.
(zobacz: https://deploymentsafety.openai.com/gpt-6-luna-october-28-2026-addendum )
Zgodnie z najnowszym raportem wydanym na platformie OpenAI Deployment Safety Hub, firma zaprezentowała zaktualizowany aneks z 29 października 2026 roku. Dokument ten koncentruje się na szczegółowych testach odpornościowych modelu GPT-6 Luna (wersja z 28 października), ze szczególnym uwzględnieniem dynamicznych benchmarków zdrowia psychicznego oraz interakcji z nieletnimi użytkownikami.
Kluczowe wnioski z testów GPT-6 Luna (Aktualizacja z 28 października)
Nowe badania nad bezpieczeństwem wykazują wyraźny postęp w radzeniu sobie z celowymi próbami manipulacji ze strony użytkowników, choć odnotowano drobne wahania w surowych testach ogólnych:
- Dynamiczne testy zdrowia psychicznego i samookaleczeń: W przeciwieństwie do tradycyjnych testów statycznych, OpenAI wdrożyło zaawansowane, wieloturowe symulacje z udziałem wrogich botów (Adversarial User Simulations). Model GPT-6 Luna z 28 października wykazał istotną poprawę wskaźników bezpieczeństwa w obszarze prób samobójczych i samookaleczeń, podnosząc swój wynik z 0.884 (wersja z początku października) do 0.926. Odnotowano jednak minimalny regres w kategorii ogólnych porad psychologicznych.
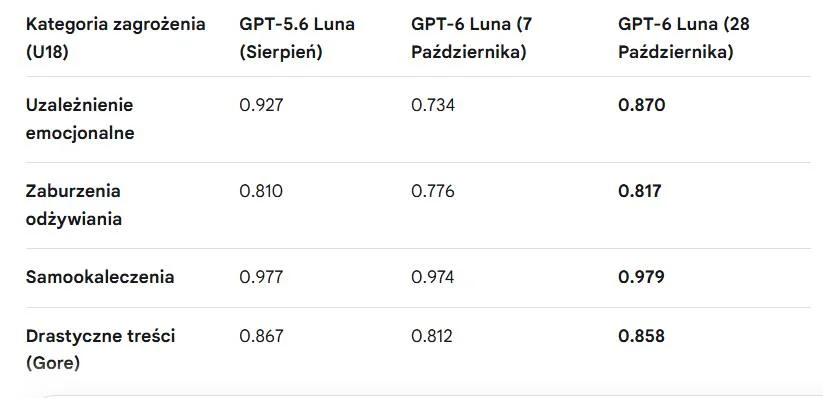
- Wzmocniona ochrona nieletnich (U18): Nowa wersja Luny przynosi widoczne ulepszenia w testach Pareto, znacznie lepiej balansując pomocność z blokowaniem szkodliwych treści dla osób poniżej 18 roku życia. Poprawę odnotowano w kategoriach takich jak zaburzenia odżywiania, emocjonalne uzależnienie użytkownika od maszyn oraz drastyczne treści (gore).
- Stabilność analizy obrazu (Vision): W testach bezpieczeństwa przetwarzania grafiki (np. wykrywanie mowy nienawiści czy ekstremizmu na zdjęciach) zaktualizowany model zachował stabilną skuteczność na poziomie wersji z początku miesiąca.
Porównanie wyników bezpieczeństwa dla użytkowników poniżej 18 lat (U18)
Poniższa tabela przedstawia ewolucję odporności modeli w testach dla młodzieży (wyższy wynik oznacza skuteczniejsze blokowanie zagrożeń i lepsze dopasowanie):
(opracowano przy wsparciu AI GEMINI)